

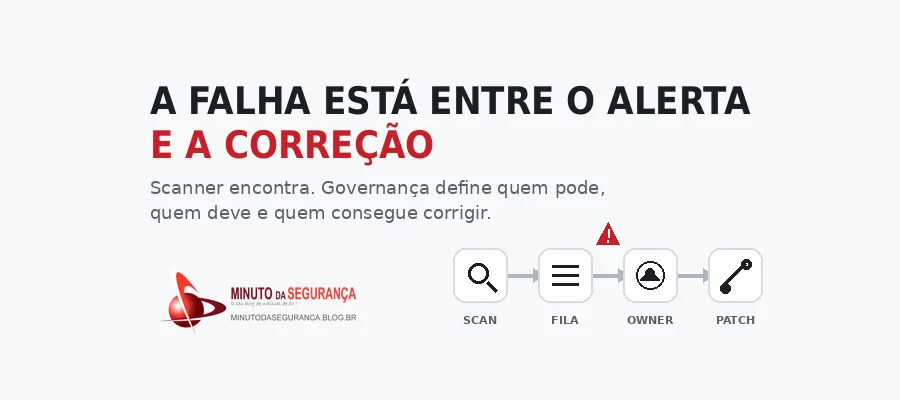
Uma fila crescente de vulnerabilidades pode parecer um problema de detecção insuficiente, mas a origem muitas vezes está em outro lugar: ativos sem responsável definido, equipes sem autoridade ou capacidade para corrigir e métricas que contam achados sem mostrar quem precisa agir. Uma análise publicada pela Dark Reading em 2 de outubro reacende essa discussão e desloca o foco do scanner para a governança da remediação.
A coluna, assinada pelo especialista Nishant Sharma, parte de uma observação simples: ampliar a cobertura de varredura faz aparecer mais problemas, mas não aumenta automaticamente a capacidade de corrigi-los. Em ambientes grandes, a descoberta pode escalar rapidamente; a remediação continua limitada por horas de engenharia, janelas de mudança, compatibilidade de aplicações, disponibilidade de patches, contratos com fornecedores e tolerância do negócio a indisponibilidade.
Esse descompasso ajuda a explicar por que organizações podem investir em scanners melhores e, ainda assim, terminar o ano com um backlog maior. O aumento da fila não prova, por si só, que o ambiente ficou menos seguro. Pode significar que a visibilidade melhorou mais rápido do que a capacidade de resposta. O problema começa quando essa diferença não é acompanhada por ownership claro, prioridade baseada em risco e cobrança sobre os prazos de remediação.
Um finding só fecha quando existe alguém capaz de agir
Para uma vulnerabilidade sair da fila, vários elementos precisam existir ao mesmo tempo. O ativo precisa ser conhecido; alguém deve ser responsável por ele; esse responsável precisa ter autoridade para alterá-lo; deve haver capacidade operacional para executar a mudança; e a correção precisa competir com outras prioridades dentro de um prazo definido.
Quando um desses elos falta, a ferramenta continua mostrando o achado, mas o processo deixa de avançar. A matéria da Dark Reading organiza esse problema em quatro situações recorrentes: ativo sem dono, dono sem autoridade, dono sem capacidade e dono sem consequência pelo descumprimento do SLA. A distinção é útil porque cada situação exige uma resposta diferente.
Um servidor sem owner verificável, por exemplo, não tem para quem escalar uma correção. Já um sistema cujo patch depende do fornecedor pode ter owner e SLA, mas nenhuma possibilidade real de ação imediata. Em outro caso, a equipe pode ter controle total sobre o ativo e ainda assim não conseguir reservar janela porque a correção disputa espaço com entregas de produto. Tratar todos esses cenários como “atraso de patch” esconde a causa.
Contar vulnerabilidades abertas pode premiar o comportamento errado
O total de findings abertos é fácil de medir e difícil de interpretar. Uma equipe que amplia a cobertura de scanner pode parecer pior mesmo tendo melhorado sua capacidade de detectar riscos. Se a meta for apenas reduzir a quantidade absoluta de vulnerabilidades, existe ainda um incentivo perverso para atacar o que é fácil de fechar, não o que representa maior risco.
Por isso, métricas operacionais precisam mostrar fluxo e responsabilidade. Tempo médio de remediação por equipe responsável, aderência ao SLA e percentual do ambiente com owner validado revelam mais sobre a capacidade de execução do que uma contagem agregada. A própria Dark Reading relata um programa em que o tempo de remediação caiu de 45 para 10 dias e a aderência ao SLA subiu de 30% para 95% em seis meses após mudanças de roteamento, escalonamento e gestão de exceções. Esses números são uma experiência relatada pelo autor, não um benchmark universal de mercado.
Notícias Relacionadas
- IA acelera descoberta de vulnerabilidades e transforma remediação no novo gargalo
- PoC público e exploração em até 48 horas: quando a fila de vulnerabilidades precisa mudar
- CISA propõe uma “era da qualidade” para o CVE diante do avanço das vulnerabilidades
Ownership sem prioridade baseada em risco também cria filas ruins
Definir um responsável não resolve sozinho o problema. A fila precisa refletir risco real. O NIST trata o patch management como manutenção preventiva e recomenda uma estratégia corporativa que cubra identificação, priorização, aquisição, instalação e verificação das correções. O CIS Control 7 segue a mesma direção ao exigir um processo documentado de gestão de vulnerabilidades e uma estratégia de remediação baseada em risco.
Na prática operacional, severidade técnica é apenas uma das entradas. Exploração conhecida, exposição à Internet, criticidade do ativo, privilégios envolvidos, alcance lateral, existência de controles compensatórios, disponibilidade do patch e impacto da mudança precisam participar da decisão. O catálogo KEV da CISA é especialmente útil porque registra vulnerabilidades com exploração conhecida e foi criado para servir como uma das entradas de priorização.
Isso evita dois extremos. O primeiro é tratar toda vulnerabilidade de alta severidade como emergência, independentemente do contexto. O segundo é usar a existência de uma fila grande como justificativa para adiar justamente os itens que já possuem evidência de exploração, exposição direta ou impacto sobre ativos críticos.
Como reduzir o backlog sem trocar de scanner
A primeira medida é reconciliar inventário e ownership. Ativos encontrados por scanners, EDRs, ferramentas de cloud, CMDB e inventários de aplicações precisam convergir para um responsável verificável — uma pessoa ou uma equipe permanente capaz de receber, priorizar e executar a remediação. “Infraestrutura” ou “TI” são rótulos organizacionais; não substituem um owner operacional.
Depois, a organização precisa formalizar a rota de decisão. Findings devem ser enviados automaticamente para a equipe responsável, com prazos definidos por risco. Exceções precisam ter justificativa, data de expiração, aprovador e controles compensatórios. Quando o prazo é rompido, a escalada deve alcançar a liderança responsável pelo ativo, e não permanecer apenas dentro da equipe de segurança.
Também é necessário reservar capacidade. Vulnerabilidades não corrigidas porque “não houve tempo” são um problema de planejamento, não apenas de segurança. Janelas de manutenção, capacidade de engenharia e critérios para interromper o roadmap quando o risco ultrapassa o limite aceitável precisam estar previstos antes da próxima emergência.
Quando um patch não pode ser aplicado, a resposta não deve ser simplesmente deixar o item aberto. Segmentação, redução de exposição, restrição de privilégio, desativação de funcionalidade, WAF, controles de acesso, monitoramento adicional ou isolamento temporário podem reduzir o risco até que a correção definitiva seja possível. O CIS reconhece explicitamente que algumas vulnerabilidades podem não ser remediadas de imediato e exigem outros controles de mitigação.
A fila precisa ter dono, prazo e motivo
Backlog de vulnerabilidades não é apenas um problema de volume. Uma fila saudável consegue responder três perguntas para cada item relevante: quem é o responsável, quando a decisão precisa acontecer e por que aquele risco está naquela posição de prioridade. Quando nenhuma delas tem resposta, o scanner está apenas documentando uma incapacidade de execução.
O alerta da Dark Reading é especialmente pertinente em um momento em que scanners, ferramentas de exposição e recursos de IA conseguem descobrir e correlacionar problemas em velocidade cada vez maior. Melhor visibilidade é valiosa, mas pode ampliar a fila se a governança da correção permanecer estática. A vantagem defensiva aparece quando descoberta e remediação evoluem juntas.
Veja também
- TeamViewer corrige cinco vulnerabilidades com risco de RCE e elevação de privilégios
- CVE-2026-94545: falha crítica no Next.js ImageResponse pode permitir execução remota de código
- Check Point sob ataque: CVE-2026-93616 expõe o plano de gestão da segurança
Be the first to comment