
Na AWS, boa parte dos incidentes relevantes não nasce de um único “serviço inseguro”, mas da relação entre identidade, permissões, workloads, rede e secrets. Um pod com uma service account excessiva, uma role IAM permissiva ou uma credencial disponível onde não deveria estar podem transformar uma falha localizada em acesso a outros serviços da conta.
A computação em nuvem deslocou parte da infraestrutura para o provedor, mas não transferiu integralmente o risco. Na AWS, a segurança funciona sob o modelo de responsabilidade compartilhada: a Amazon protege a infraestrutura física e os serviços que compõem a nuvem, enquanto o cliente continua responsável por identidades, configurações, dados, sistemas operacionais quando aplicável, aplicações, permissões e uso seguro dos recursos contratados.
Uma arquitetura pode usar serviços altamente resilientes e continuar vulnerável por permissões excessivas, buckets públicos, regras de rede amplas, imagens de container desatualizadas, credenciais estáticas ou logging incompleto. A AWS entrega mecanismos de proteção; o risco aparece na forma como esses mecanismos são combinados e operados.
A primeira fronteira é a identidade — inclusive a dos workloads
O primeiro controle crítico é estrutural. Ambientes corporativos devem evitar concentrar produção, desenvolvimento, segurança, auditoria e experimentação em uma única conta. O uso de AWS Organizations, múltiplas contas, unidades organizacionais e Service Control Policies permite criar barreiras administrativas e reduzir o raio de impacto de um comprometimento. Contas dedicadas para segurança e arquivamento de logs ajudam a preservar segregação de funções e evidências.
Para usuários humanos, a AWS recomenda federação e credenciais temporárias, preferencialmente pelo IAM Identity Center ou por um provedor corporativo. Para máquinas, o mesmo princípio vale: EC2, Lambda e pods do EKS devem receber identidades próprias e temporárias, evitando access keys gravadas em código, imagens ou variáveis de pipeline. Em EKS, isso significa tratar service accounts, RBAC e EKS Pod Identity como parte do mesmo problema de IAM. MFA permanece obrigatório nos acessos humanos sensíveis, e a conta root deve ser protegida de forma excepcional, sem access keys permanentes.
Exemplo: uma aplicação em EC2 que precisa ler apenas um bucket específico não deveria receber uma política ampla como AmazonS3FullAccess. A role associada à instância deve permitir somente as ações e os recursos necessários. Se essa instância for comprometida, o atacante herdará apenas o conjunto mínimo de permissões, reduzindo o impacto potencial.
Rede: exposição mínima e segmentação deliberada
Security Groups e Network ACLs devem ser tratados como controles de política, não como simples configurações de conectividade. Portas administrativas expostas à Internet, regras 0.0.0.0/0 desnecessárias e comunicação irrestrita entre ambientes aumentam a superfície de ataque. VPCs separadas, sub-redes privadas, endpoints privados para serviços AWS e VPC Flow Logs ampliam a capacidade de segmentar e observar o tráfego.
Serviços publicados na Internet podem exigir AWS WAF, CloudFront, proteção contra DDoS e, em arquiteturas de maior risco, AWS Network Firewall ou controles equivalentes de terceiros. O objetivo não é empilhar produtos, mas limitar caminhos possíveis de ataque e tornar comunicações legítimas previsíveis e auditáveis.
Secrets e permissões podem ligar um workload a serviços que ele nunca deveria alcançar
A proteção de dados combina classificação, controle de acesso, criptografia e recuperação. Em S3, Block Public Access deve ser a linha de base para buckets que não exigem exposição pública. Políticas de bucket, Access Points e IAM devem ser revisados para identificar acessos externos ou entre contas. Dados sensíveis podem ser identificados com Amazon Macie, enquanto AWS KMS oferece governança de chaves para criptografia em repouso.
Segredos de aplicações não deveriam aparecer em código-fonte, variáveis expostas de pipeline ou imagens de container. O problema fica mais sério quando o secret entrega acesso que o workload não teria por sua própria identidade. Um pod comprometido com permissão para ler um segredo de banco de dados, por exemplo, pode ganhar um segundo caminho de acesso fora do controle do RBAC. Secrets Manager e Systems Manager Parameter Store ajudam a centralizar credenciais, mas a política de leitura desses segredos continua sendo tão importante quanto o armazenamento.
Logging, rastreabilidade e detecção
CloudTrail é um dos controles mais importantes porque registra atividade de API e ajuda a responder perguntas fundamentais: quem realizou uma ação, quando, em qual conta, região e recurso. A AWS recomenda trilhas multirregionais e, em ambientes com Organizations, trilhas de organização. Os logs devem ser enviados para bucket centralizado, com acesso restrito, criptografia e validação de integridade.
AWS Config complementa essa camada registrando estado e alterações de configuração. Security Hub CSPM agrega descobertas e permite avaliar a postura contra padrões como AWS Foundational Security Best Practices e CIS AWS Foundations Benchmark. A versão 5.0.0 do benchmark CIS já é suportada pelo Security Hub CSPM, mas sua eficácia depende da cobertura correta do AWS Config e dos recursos efetivamente registrados.
GuardDuty adiciona detecção de ameaças com análise de sinais como CloudTrail, VPC Flow Logs, DNS, logs de auditoria do EKS e eventos de runtime quando o recurso está habilitado. O ponto operacional é importante: ativar o serviço sem tratar findings, definir responsáveis, integrar alertas e estabelecer playbooks apenas cria mais telemetria sem reduzir o risco.
Vulnerabilidades: infraestrutura, imagens e código precisam entrar no mesmo processo
Amazon Inspector pode identificar vulnerabilidades em EC2, imagens armazenadas no ECR e funções Lambda. Em ambientes de containers, a gestão de vulnerabilidades deve começar antes da implantação, no pipeline CI/CD, e continuar durante a execução. Imagens base desatualizadas, pacotes vulneráveis e dependências abandonadas não deveriam chegar à produção apenas porque o cluster está protegido.
Ferramentas adicionais também podem ampliar cobertura. O Trivy, por exemplo, consegue verificar vulnerabilidades e problemas de configuração em Docker, Kubernetes, Terraform, CloudFormation e outros artefatos de Infrastructure as Code. Em programas maduros, ferramentas nativas e externas são combinadas para avaliar build, IaC, imagens, dependências, configuração da conta e comportamento em runtime.
Proteção de Kubernetes no Amazon EKS
No EKS, a AWS gerencia o control plane, mas isso não elimina a responsabilidade do cliente sobre identidades, nodes, add-ons, workloads, imagens, políticas de rede, secrets, RBAC e configuração dos pods. Um cluster funcional pode continuar inseguro se namespaces se comunicarem livremente, service accounts receberem privilégios excessivos ou containers executarem como root sem necessidade.
A própria documentação do EKS destaca que a comunicação entre pods é permitida por padrão. Network Policies devem ser utilizadas para restringir tráfego leste-oeste, e a AWS recomenda combiná-las com Security Groups for Pods para uma defesa em camadas. Essa combinação ajuda a controlar tanto a comunicação interna entre pods quanto o acesso a serviços AWS externos ao cluster.
A política de segurança deve incluir Pod Security Standards, restrição de containers privilegiados, execução como usuário não-root sempre que possível, sistemas de arquivos somente leitura quando aplicável, seccomp, limites de capabilities, RBAC mínimo e isolamento de namespaces. Para acesso a serviços AWS, EKS Pod Identity ou mecanismos equivalentes devem evitar o compartilhamento de credenciais amplas entre workloads.
No runtime, o GuardDuty pode monitorar eventos como execução de processos, conexões de rede e acesso a arquivos dentro dos workloads EKS. A proteção deve ser complementada por logs de auditoria do Kubernetes e varredura contínua das imagens. O artigo recente do Minuto da Segurança sobre ataques de identidade em SPIFFE/SPIRE reforça o mesmo princípio: quando um node privilegiado é comprometido, a confiança atribuída às identidades dos workloads pode ser afetada.
Notícias Relacionadas
- Ataque de identidade no Kubernetes expõe limite de confiança do SPIFFE/SPIRE
- CVE-2026-89049 no AWS SSM Agent: falha de SSRF pode expor credenciais IAM
- 7 passos para tornar sistemas cloud-native mais seguros em 2026
As falhas mais observadas em assessments de AWS
Embora cada ambiente tenha particularidades, alguns padrões aparecem repetidamente: contas sem segregação adequada; usuários ou workloads com privilégios administrativos; access keys antigas; Security Groups excessivamente permissivos; recursos expostos sem necessidade; ausência de CloudTrail organizacional; AWS Config incompleto; buckets ou snapshots compartilhados de forma inadequada; criptografia e rotação de chaves inconsistentes; backups sem teste de restauração; imagens vulneráveis; secrets espalhados; e clusters Kubernetes sem segmentação ou política de segurança de pods.
Outro problema recorrente é a diferença entre serviço habilitado e controle operando. Um Security Hub com centenas de findings críticos sem owner ou SLA não representa maturidade. O mesmo vale para GuardDuty sem resposta, CloudTrail sem proteção contra alteração, Inspector sem processo de remediação e backups que nunca foram restaurados em teste.
Controles críticos que não deveriam depender de decisão manual
Alguns controles devem ser tratados como guardrails organizacionais: proteção da conta root, federação e MFA; restrições por SCP; bloqueio de exposição pública indevida; CloudTrail e Config em todas as contas e regiões aplicáveis; centralização de logs; criptografia por padrão; gestão de vulnerabilidades; backups protegidos; detecção de ameaças; e política mínima para workloads de Kubernetes. Quanto mais desses controles puderem ser definidos como código e validados automaticamente no pipeline, menor a dependência de configuração humana.
Isso também vale para Infrastructure as Code. Terraform e CloudFormation precisam passar por validações antes do deploy. Um template que cria um bucket público, uma role com *:* ou um Security Group com SSH aberto para a Internet deveria falhar no pipeline, em vez de depender de uma auditoria posterior.
Como executar um assessment de segurança AWS
Um assessment consistente deve começar pelo escopo: contas, regiões, workloads, dados críticos, EKS, dependências externas e requisitos regulatórios. Em seguida, a equipe deve coletar evidências técnicas e avaliar arquitetura, IAM, rede, armazenamento, criptografia, logging, vulnerabilidades, resiliência, containers e resposta a incidentes.
O AWS Well-Architected Framework, especialmente o pilar Security, fornece perguntas e princípios para revisar workloads. Security Hub CSPM e AWS Config ajudam a identificar desvios técnicos. AWS Audit Manager pode automatizar a coleta contínua de evidências provenientes de Security Hub, Config, CloudTrail e APIs, mas a própria AWS ressalta que o serviço auxilia na coleta de evidências e não substitui a avaliação de conformidade ou o julgamento do auditor.
Um assessment independente deve ir além do checklist. É necessário validar se o controle é aplicável, se cobre todas as contas e regiões, se está efetivamente coletando dados, se os alertas chegam aos responsáveis e se há capacidade de correção. Também é importante testar caminhos de ataque: abuso de permissões IAM, exposição de storage, movimentação lateral, acesso administrativo, falhas de segmentação, uso de credenciais comprometidas e impacto de um workload vulnerável sobre recursos adjacentes.
Exemplo: um finding que aponta uma role excessivamente permissiva deve ser correlacionado com o recurso que a utiliza, dados acessíveis, possibilidade de assumir outras roles e evidências de uso. Isso transforma uma configuração abstrata em risco de negócio e ajuda a priorizar a remediação.
Prioridade: corrigir pelo risco, não pelo volume de findings
Ambientes AWS extensos podem gerar milhares de alertas. Corrigir apenas por severidade nominal produz filas pouco eficientes. A prioridade deve considerar criticidade do ativo, exposição, explorabilidade, privilégios alcançáveis, sensibilidade dos dados, presença de compensações e evidência de atividade maliciosa.
Uma vulnerabilidade crítica em uma imagem que não está em execução pode ser menos urgente do que uma combinação de credencial exposta, role privilegiada e recurso acessível publicamente. O processo de gestão de risco precisa correlacionar contexto para decidir o que realmente deve ser atacado primeiro.
Conclusão
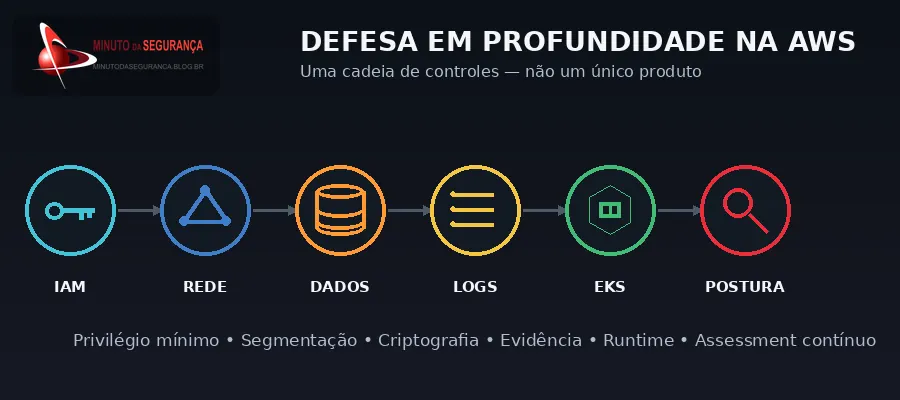
Segurança em AWS é uma disciplina operacional contínua. O provedor entrega uma infraestrutura robusta e um conjunto amplo de serviços de proteção, mas a organização continua responsável por transformar esses recursos em controles coerentes. Identidade, segmentação, dados, logs, gestão de vulnerabilidades, EKS, detecção, resiliência e auditoria precisam funcionar como uma única arquitetura de defesa.
Um programa de cloud security precisa provar que uma identidade comprometida não consegue avançar livremente entre contas, workloads e dados. Guardrails, assessments e automação ajudam quando verificam esse caminho de ponta a ponta — e não apenas quando reduzem o número de findings em um painel.
Referências
- AWS — Shared Responsibility Model e segurança da VPC
- AWS — Security best practices in IAM
- AWS — CIS AWS Foundations Benchmark no Security Hub CSPM
- AWS — Security best practices in CloudTrail
- AWS — Amazon EKS network security best practices
- AWS — Amazon EKS runtime security
- AWS — Well-Architected Framework: Security Pillar
- AWS — AWS Audit Manager
- Trivy — Misconfiguration Scanning


Be the first to comment