

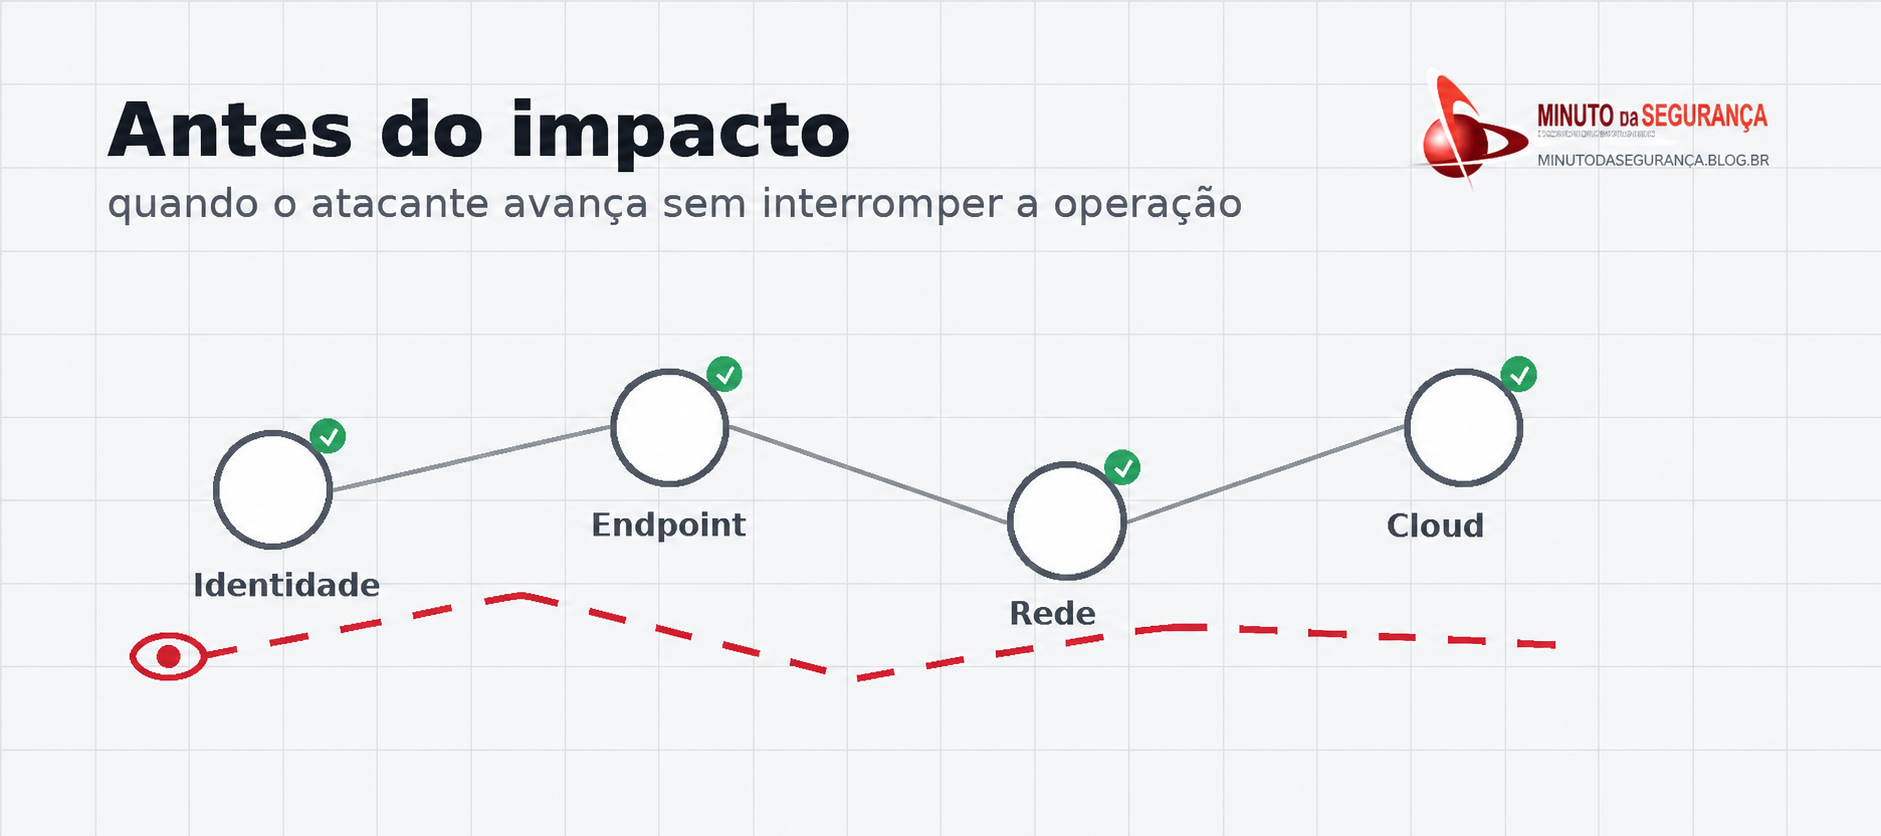
Um ambiente pode continuar autenticando usuários, processando pedidos e respondendo normalmente enquanto um invasor já obteve acesso, criou persistência e começa a ampliar privilégios. O intervalo entre o primeiro acesso e a resposta efetiva é uma das janelas mais perigosas da segurança moderna — justamente porque, para o negócio, quase nada parece ter mudado.
Os incidentes mais fáceis de reconhecer são os que interrompem alguma coisa. Sistemas indisponíveis, arquivos criptografados, telas bloqueadas ou aplicações que deixam de responder transformam o ataque em um problema visível. A dificuldade aumenta quando o atacante consegue operar dentro do ambiente sem produzir um sintoma suficientemente forte para interromper a rotina.
Esse tipo de situação não depende de uma técnica exótica. Uma credencial válida, uma sessão remota autorizada pelo próprio usuário, um endpoint comprometido ou uma conta com privilégios excessivos podem permitir que ações maliciosas se misturem ao tráfego legítimo. O desafio deixa de ser apenas bloquear uma entrada e passa a incluir reconhecer uma sequência de comportamentos que, isoladamente, pode parecer normal.
Quando o incidente aparece depois do acesso
Em setembro de 2026, a Thomson Reuters informou um incidente envolvendo sua plataforma C-Track. Segundo a companhia e informações divulgadas pela Reuters, arquivos foram obtidos por uma parte não autorizada em março, enquanto a atividade foi detectada em 30 de junho. O intervalo é relevante, mas deve ser interpretado com cuidado: as informações públicas confirmam quando os arquivos foram obtidos e quando o incidente foi detectado, não que o invasor tenha permanecido continuamente ativo durante todo esse período.
A distinção é importante porque tempo entre comprometimento e descoberta não equivale necessariamente a tempo de permanência ininterrupta. Ainda assim, o caso expõe uma dificuldade recorrente: quando um acesso não derruba serviços e não produz um evento claramente destrutivo, a investigação depende da capacidade de reconstruir atividade, correlacionar logs e identificar comportamentos que não deveriam ter ocorrido.
Uma chamada de suporte pode virar ransomware em menos de um dia
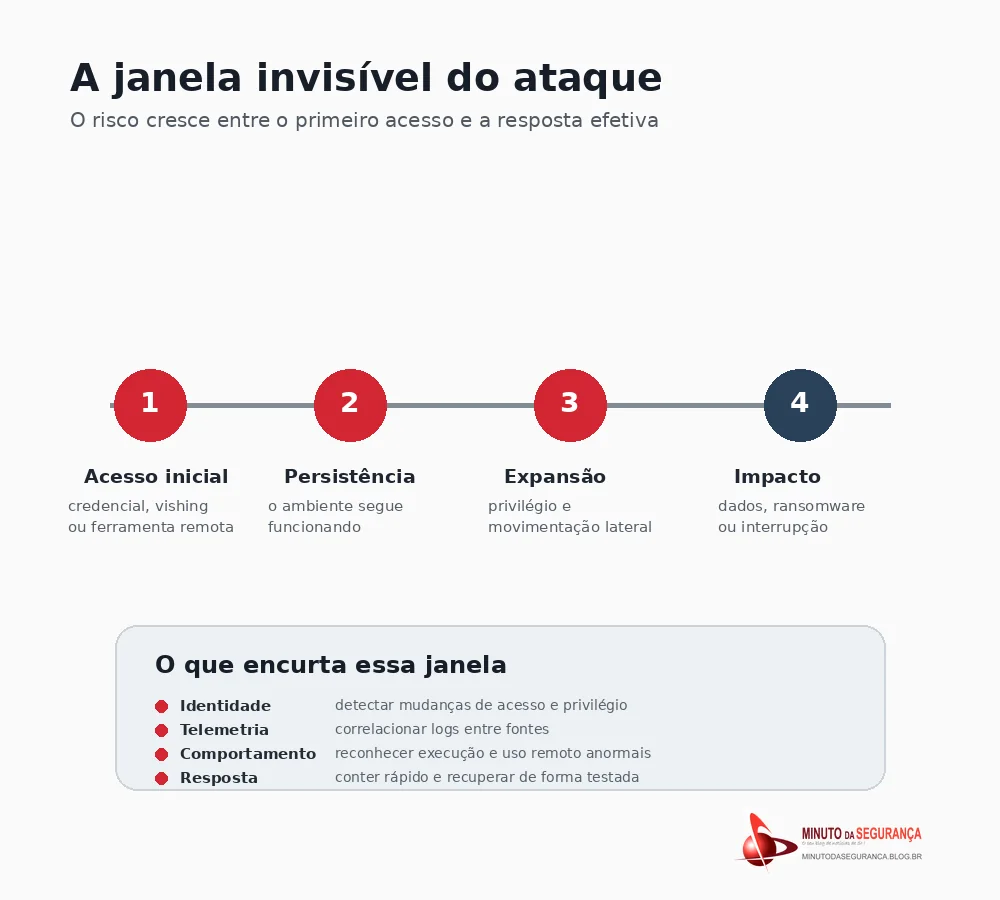
A campanha STAC4749, investigada pela Sophos entre fevereiro e junho de 2026, mostra o outro extremo. Os operadores abordavam funcionários pelo Microsoft Teams, apresentando-se como profissionais de suporte ou help desk, e tentavam convencê-los a conceder acesso remoto. Depois da entrada inicial, a operação usava ferramentas de pós-exploração, mecanismos de persistência e acesso remoto para ampliar o controle sobre os sistemas.
Em pelo menos três comprometimentos analisados pela Sophos, a cadeia terminou na implantação do ransomware Chaos. Em um deles, o intervalo entre o acesso inicial e a criptografia foi inferior a 17 horas. É um cenário muito diferente do caso C-Track: em vez de uma descoberta tardia de atividade ocorrida meses antes, há uma progressão rápida, iniciada por engenharia social e sustentada por ações que se confundem com atividades administrativas legítimas.
Esse é o ponto em que controles centrados apenas na autenticação ficam insuficientes. Depois que o usuário aceita a sessão ou o atacante utiliza uma identidade válida, a pergunta muda de “quem conseguiu entrar?” para “o que essa identidade passou a fazer depois que entrou?”. Execução de PowerShell, criação de persistência, instalação de ferramentas remotas, alterações de privilégios e movimentação entre sistemas precisam ser observadas como parte de uma mesma história.
O problema não termina quando o atacante é contido
A Stryker enfrentou uma dimensão diferente do mesmo problema em março de 2026. A companhia informou que um ataque cibernético provocou uma interrupção global em seu ambiente Microsoft, afetando processamento de pedidos, manufatura e expedição. A empresa declarou que não havia indicação de ransomware ou malware, ativou seu plano de resposta e adotou medidas de continuidade enquanto restaurava os sistemas.
O caso ajuda a separar duas capacidades que frequentemente são tratadas como uma só. Conter o incidente é impedir que ele continue avançando. Recuperar o ambiente é restabelecer processos, dados, integrações e operações em condições confiáveis. Uma empresa pode conseguir bloquear o atacante e ainda permanecer dias ou semanas lidando com reconstrução, validação e retorno gradual dos serviços.
Notícias Relacionadas
- Vishing contra o suporte de TI: como criminosos contornam MFA e invadem o SaaS
- Visibilidade de identidade em 2026: por que saber quem pode acessar já não é suficiente
- Falhas na segmentação de rede: quando uma invasão encontra caminho para se espalhar
Visibilidade não é acumular alertas
Quanto mais distribuído o ambiente, menor a chance de um único sensor contar toda a história. Identidade pode mostrar uma alteração de autenticação; o endpoint, um processo incomum; o firewall, uma conexão inesperada; a plataforma SaaS, uma mudança de configuração; o serviço de nuvem, uma elevação de privilégio. Cada evento isolado pode ter uma explicação legítima. A correlação é o que transforma sinais dispersos em contexto.
Por isso, monitoramento efetivo exige mais do que encaminhar logs para um repositório central. A organização precisa saber quais eventos são relevantes, preservar registros suficientes para investigação, sincronizar fontes, estabelecer comportamentos esperados e criar capacidade de responder quando uma combinação de sinais indicar progressão de ataque. A orientação do NIST para resposta a incidentes trata detecção, resposta e recuperação como partes integradas da gestão de risco, enquanto a CISA recomenda logging de atividades de usuários, ações administrativas, tráfego, logins e eventos de sistemas com centralização e monitoramento de ocorrências de maior risco.
Essa lógica também reduz o risco de interpretar “mais alertas” como “mais visibilidade”. Um SOC que recebe milhares de eventos sem contexto pode detectar menos do que uma equipe que acompanha um conjunto menor de sinais com boa telemetria, regras coerentes e capacidade de investigação.
O que reduz a janela para o atacante
A defesa precisa combinar prevenção, detecção e capacidade operacional. Identidades privilegiadas devem ser limitadas e monitoradas; MFA resistente a phishing deve ser priorizada onde aplicável; ferramentas de acesso remoto precisam de governança; endpoints e workloads devem produzir telemetria útil; a rede deve limitar deslocamentos desnecessários; e logs críticos precisam permanecer disponíveis mesmo quando um atacante tenta alterar ou apagar evidências.
A segmentação merece atenção especial porque transforma uma credencial comprometida em um problema menor quando o acesso daquela identidade não abre caminhos para sistemas que ela não deveria alcançar. O mesmo vale para privilégios: uma conta usada para suporte não deveria, por conveniência operacional, possuir capacidade equivalente à de uma identidade administrativa ampla.
Planos de resposta também precisam sair do papel. Exercícios de tabletop, simulações técnicas, testes de restauração, contatos alternativos e critérios claros de isolamento reduzem o tempo gasto decidindo quem pode interromper um sistema, revogar uma sessão, bloquear uma integração ou ativar procedimentos de continuidade. Em um incidente real, minutos consumidos em dúvida organizacional podem valer tanto quanto uma falha técnica.
Risco técnico e impacto de negócio aparecem em momentos diferentes
Uma intrusão silenciosa pode começar sem impacto operacional e terminar em exfiltração, fraude, ransomware ou sabotagem. O inverso também ocorre: a contenção pode ser bem-sucedida, mas a própria resposta exige desligar sistemas, suspender integrações ou restaurar ambientes, produzindo impacto para clientes e operações.
Essa diferença explica por que resiliência cibernética não pode ser reduzida à existência de backup. A organização precisa conhecer dependências críticas, identificar quais processos suportam operação degradada, validar tempos de recuperação e ter confiança de que credenciais, configurações e dados usados na restauração não carregam o comprometimento de volta para o ambiente.
O momento mais perigoso pode parecer um dia normal
Os casos de C-Track, STAC4749 e Stryker não descrevem o mesmo tipo de incidente e não devem ser tratados como uma única cadeia de ataque. Juntos, porém, ajudam a visualizar três problemas que frequentemente se encontram: comprometimentos que só aparecem depois, ataques que aceleram rapidamente após uma interação humana e operações que continuam sofrendo consequências mesmo depois da contenção.
É por isso que a pergunta “estamos protegidos?” é insuficiente. Uma organização também precisa saber se consegue reconhecer comportamentos que não combinam entre si, reconstruir o que ocorreu, conter um acesso antes que ele se amplie e recuperar os serviços sem depender de improviso. Em muitos ataques, a janela mais crítica começa antes de qualquer tela parar de funcionar.
Veja também
- Segurança de identidades: por que a defesa começa antes do login
- Recuperação de IA: só 45% das empresas brasileiras pesquisadas têm planos abrangentes
- n0n ransomware ameaça destruir backups para ampliar pressão sobre vítimas
Referências
- Thomson Reuters detects cybersecurity incident, says unauthorized party accessed files
- Chaos in Teams vishing
- Customer Updates: Stryker Network Disruption
- Incident Response Recommendations and Considerations for Cybersecurity Risk Management: A CSF 2.0 Community Profile
- Use Logging on Business Systems
- Contribuição Moov4


Be the first to comment