

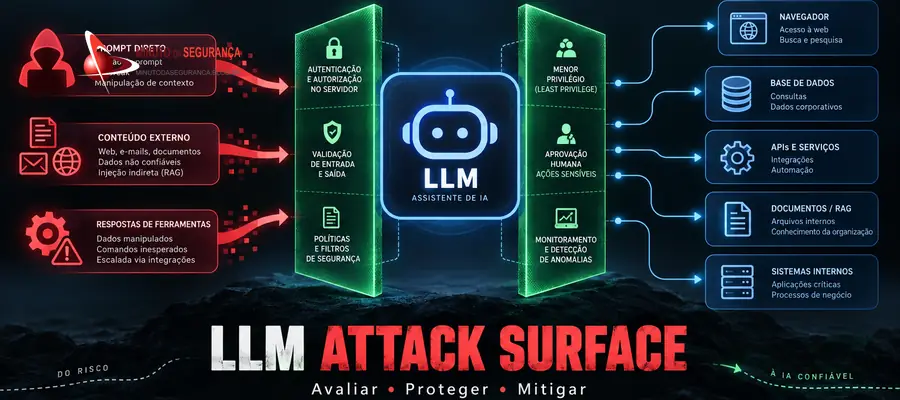
Aplicações com modelos de linguagem deixaram de ser apenas interfaces de conversação: hoje consultam bases internas, executam funções, acionam APIs e tomam decisões dentro de fluxos de negócio. Essa capacidade amplia o valor da IA generativa, mas também cria uma superfície de ataque que precisa ser tratada como parte da arquitetura de segurança da aplicação.
O problema não está apenas no modelo
Uma aplicação baseada em Large Language Model (LLM) raramente termina no próprio modelo. O ambiente real inclui o prompt do usuário, instruções de sistema, memória, RAG, documentos, plugins, ferramentas, APIs, bancos de dados, mecanismos de autenticação e a camada que interpreta a saída gerada. É nesse conjunto que a superfície de ataque se forma.
A PortSwigger propõe uma forma particularmente útil de começar a avaliação: identificar todas as entradas do LLM, descobrir quais dados e APIs estão ao alcance do modelo e, em seguida, testar essa nova superfície como se faria com qualquer aplicação web — sem assumir que o modelo será capaz de impor sozinho as políticas de segurança. A analogia com SSRF ajuda a entender o risco: o atacante pode tentar transformar um componente com mais acesso em intermediário para atingir recursos que ele próprio não alcançaria diretamente.
Mapa da superfície de ataque
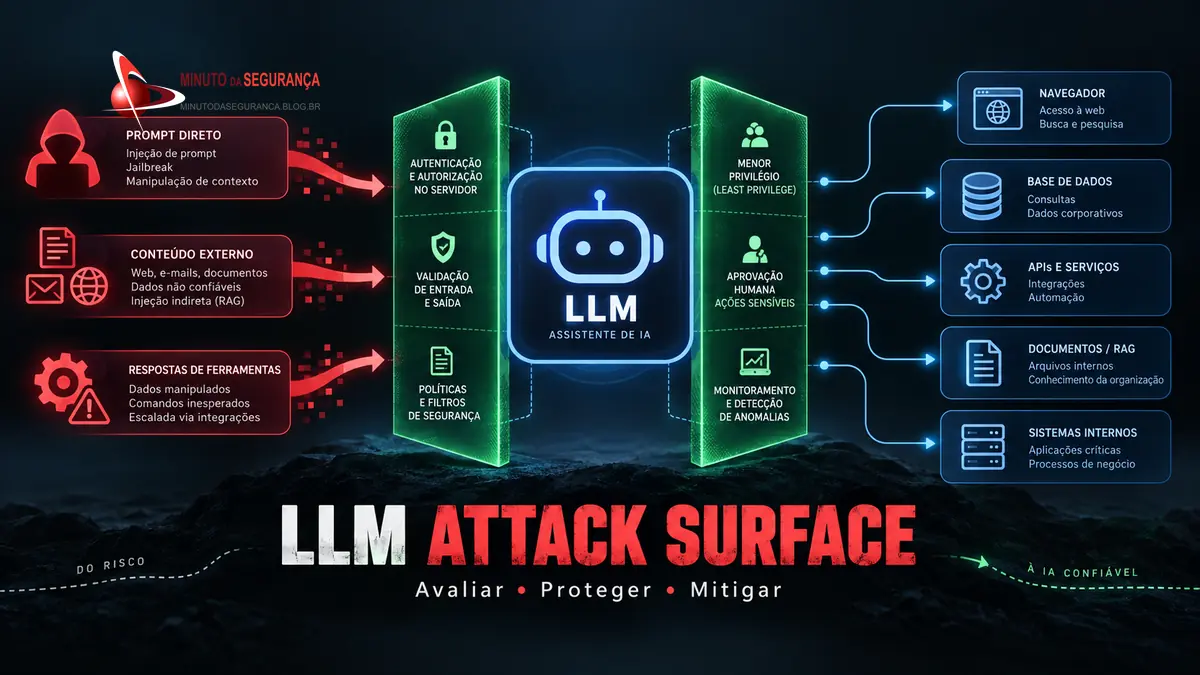
O primeiro trabalho da equipe de segurança deve ser arquitetural. É necessário registrar de onde o LLM recebe informação e o que pode acontecer depois que ele processa essa informação. Entradas diretas, como prompts e arquivos enviados pelo usuário, são apenas uma parte do problema. Conteúdo recuperado de páginas web, e-mails, documentos corporativos, bases vetoriais e respostas de ferramentas também pode transportar instruções hostis.
O mesmo raciocínio vale para as saídas. Uma resposta exibida apenas como texto possui um perfil de risco diferente de uma resposta que será renderizada como HTML, transformada em consulta, enviada a outra API ou interpretada por um agente capaz de executar ações. Quanto maior a capacidade de agir, maior deve ser a separação entre o raciocínio probabilístico do modelo e a autorização determinística da aplicação.
1. Prompt injection: tratar conteúdo como dado, não como autoridade
Prompt injection ocorre quando uma entrada altera o comportamento esperado do modelo. O ataque pode ser direto, enviado pelo próprio usuário, ou indireto, escondido em uma fonte que a aplicação consulta. Uma página web, mensagem, documento ou registro recuperado por RAG pode conter texto projetado para ser interpretado como instrução.
Essa segunda forma é especialmente relevante em agentes. Um usuário pode pedir o resumo de um e-mail legítimo e, dentro do conteúdo recuperado, existir uma instrução tentando convencer o modelo a criar uma regra de encaminhamento, acessar outro recurso ou revelar dados. O controle não deve depender apenas de frases no system prompt como “ignore instruções maliciosas”. A própria PortSwigger alerta que restrições baseadas exclusivamente em prompting podem ser contornadas por entradas cuidadosamente construídas.
2. Excessive agency: quando o LLM recebe poder demais
O risco cresce quando o modelo pode chamar ferramentas. Uma API aparentemente simples pode permitir leitura de dados sensíveis; outra pode alterar contas; uma função de depuração pode aceitar comandos excessivamente flexíveis. Se a aplicação delega ao LLM a decisão sobre o que pode ser feito, uma manipulação de contexto pode transformar uma conversa em uma ação de alto impacto.
A OWASP classifica esse problema como Excessive Agency. A proteção começa pelo princípio do menor privilégio: disponibilizar apenas as ferramentas necessárias, limitar parâmetros, separar identidades de serviço e fazer com que o sistema de destino valide autenticação e autorização em cada operação. O LLM pode sugerir uma ação; ele não deve ser a autoridade que decide se aquela ação é permitida.
3. Insecure output handling: a resposta também é entrada
Outro erro recorrente é confiar na saída do modelo. Se texto produzido pelo LLM é inserido em HTML, SQL, shell, templates ou chamadas de API sem validação adequada, a aplicação pode reintroduzir classes tradicionais de vulnerabilidade, como XSS, injeção de comandos ou requisições indevidas. A PortSwigger demonstra esse encadeamento em seus laboratórios: a manipulação do modelo pode produzir uma saída que explora uma vulnerabilidade em outro componente.
Por isso, a saída deve ser tratada como conteúdo não confiável. Sanitização contextual, encoding, consultas parametrizadas, schemas rígidos, allowlists e validação no componente consumidor continuam sendo necessários. IA generativa não substitui práticas consolidadas de AppSec.
4. Vazamento de dados e system prompts
Dados sensíveis podem aparecer no contexto por treinamento, fine-tuning, RAG, histórico de conversa, memória, logs ou respostas de ferramentas. A estratégia defensiva deve partir da hipótese de que qualquer informação entregue ao modelo pode, em determinadas condições, influenciar uma resposta futura.
O system prompt também não deve funcionar como cofre. A OWASP recomenda não tratá-lo como segredo nem armazenar nele credenciais, strings de conexão ou mecanismos de autorização. Se a segurança depende de o usuário nunca descobrir uma instrução interna, o desenho já possui uma fragilidade estrutural.
5. RAG, embeddings e fontes externas
Arquiteturas RAG acrescentam outra fronteira. Documentos precisam de classificação, controle de acesso e proveniência antes de entrarem no índice; a recuperação deve respeitar a identidade e o escopo do usuário; e conteúdo recuperado precisa continuar sendo considerado não confiável. Uma base vetorial não elimina a necessidade de autorização apenas porque a consulta é semântica.
Também é importante separar instruções de aplicação, dados recuperados e conteúdo fornecido pelo usuário. Essa separação não torna prompt injection impossível, mas reduz ambiguidades e facilita a aplicação de políticas, filtros, observabilidade e testes.
Metodologia prática de avaliação
Uma avaliação madura combina threat modeling, testes manuais, automação e revisão da arquitetura. O ponto de partida pode ser organizado em cinco movimentos: mapear entradas e saídas; inventariar dados, ferramentas e permissões; construir cenários de abuso; validar controles nos sistemas downstream; e medir o impacto quando o modelo se comporta de forma inesperada.
Nos testes, a equipe deve variar não apenas a redação do prompt, mas também a origem do conteúdo. É importante avaliar instruções diretas, conteúdo indireto em documentos e páginas, respostas maliciosas de ferramentas, dados recuperados por RAG e cadeias em que uma saída do modelo alimenta outro componente. O objetivo não é provar que o modelo “obedece” a uma frase específica, mas descobrir se uma manipulação pode atravessar limites de confiança.
Checklist de avaliação
- Quais entradas diretas e indiretas chegam ao modelo?
- Quais dados o modelo consegue consultar e com qual identidade?
- Quais ferramentas, plugins e APIs estão disponíveis?
- Alguma ferramenta permite ações de escrita, exclusão, transferência ou alteração de configuração?
- Onde autenticação e autorização são realmente aplicadas?
- Como a saída é validada antes de chegar a navegador, API, banco, shell ou outro agente?
- Há confirmação humana para ações sensíveis ou irreversíveis?
- RAG e memória respeitam segregação por usuário, tenant e classificação da informação?
- Logs registram chamadas de ferramentas, decisões, falhas de política e mudanças de privilégio?
- Existem limites de consumo, taxa, custo e volume para conter abuso?
Proteção em camadas: o modelo não deve ser o firewall
A defesa eficaz distribui controles ao redor do LLM. Autenticação, autorização e validação de parâmetros devem permanecer nos serviços que executam as operações. Ferramentas devem expor funções estreitas em vez de interfaces genéricas. Contas usadas por agentes precisam de privilégios mínimos e, quando possível, credenciais temporárias e escopo específico.
Para operações de maior risco, a aplicação deve introduzir confirmação explícita, políticas determinísticas e separação entre planejar e executar. Um modelo pode preparar uma solicitação de mudança, mas uma camada independente deve verificar identidade, permissão, parâmetros e contexto antes da execução. Em ações irreversíveis, a aprovação humana pode ser um controle essencial.
Entradas e saídas devem passar por validação contextual. Conteúdo externo precisa carregar marcação de proveniência e nível de confiança. Segredos devem ficar fora de prompts. APIs devem aplicar rate limiting, quotas e limites de custo. A telemetria precisa permitir reconstruir quais dados foram recuperados, quais ferramentas foram chamadas e qual política autorizou cada ação.
Red teaming contínuo e segurança no ciclo de desenvolvimento
LLMs são probabilísticos e integrações mudam rapidamente. Um teste pontual não é suficiente. Novos modelos, prompts, ferramentas, conectores e fontes de conhecimento podem alterar o comportamento da aplicação sem uma mudança evidente na interface. Por isso, cenários de prompt injection, abuso de ferramentas, exfiltração e manipulação de saída devem entrar no processo de testes de segurança e regressão.
O NIST AI RMF Generative AI Profile reforça a necessidade de incorporar gestão de risco ao ciclo de vida da IA generativa. Na prática, isso aproxima segurança de IA de disciplinas já conhecidas: inventário, avaliação de impacto, governança de mudanças, testes, monitoramento, resposta a incidentes e melhoria contínua.
O que muda para AppSec e Segurança da Informação
A principal mudança é de fronteira. A equipe deixa de avaliar somente endpoints e código determinístico e passa a considerar também contexto, instruções, fontes de conhecimento e decisões mediadas por modelos. Ainda assim, muitos controles fundamentais permanecem familiares: menor privilégio, mediação completa, validação, segregação, defesa em profundidade, logging e testes adversariais.
O risco de LLM não deve ser isolado como um problema “do time de IA”. Ele atravessa AppSec, IAM, segurança de APIs, proteção de dados, arquitetura, desenvolvimento e governança. Quanto mais um modelo puder consultar, decidir e agir, mais importante será garantir que os limites reais estejam fora dele.
Zero Trust para LLMs: por que a IA generativa precisa operar sem confiança implícita
IA amplia desafio de segurança e governança nas redes corporativas
Conclusão
A pergunta central não é se um LLM pode ser convencido a produzir uma resposta inesperada. Em sistemas conectados, o ponto decisivo é o que essa resposta consegue alcançar. Uma arquitetura segura presume que o modelo pode errar, ser manipulado ou interpretar dados como instruções e limita o impacto antes que isso se transforme em comprometimento.
O caminho mais consistente combina mapeamento da superfície de ataque, menor privilégio, autorização fora do modelo, validação de entradas e saídas, proteção de dados, observabilidade e testes adversariais recorrentes. A IA pode permanecer flexível; os limites de segurança, porém, precisam ser determinísticos.
Zero Trust para LLMs: por que a IA generativa precisa operar sem confiança implícita
Shadow AI: 3 medidas para reduzir o risco de cibersegurança
Dependência de IA pode criar um novo risco corporativo
Referências
PortSwigger Web Security Academy — Web LLM attacks
OWASP GenAI Security Project — Top 10 Risk & Mitigations for LLMs and Gen AI Apps
OWASP GenAI Security Project — LLM06:2025 Excessive Agency
NIST — Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile

Be the first to comment