

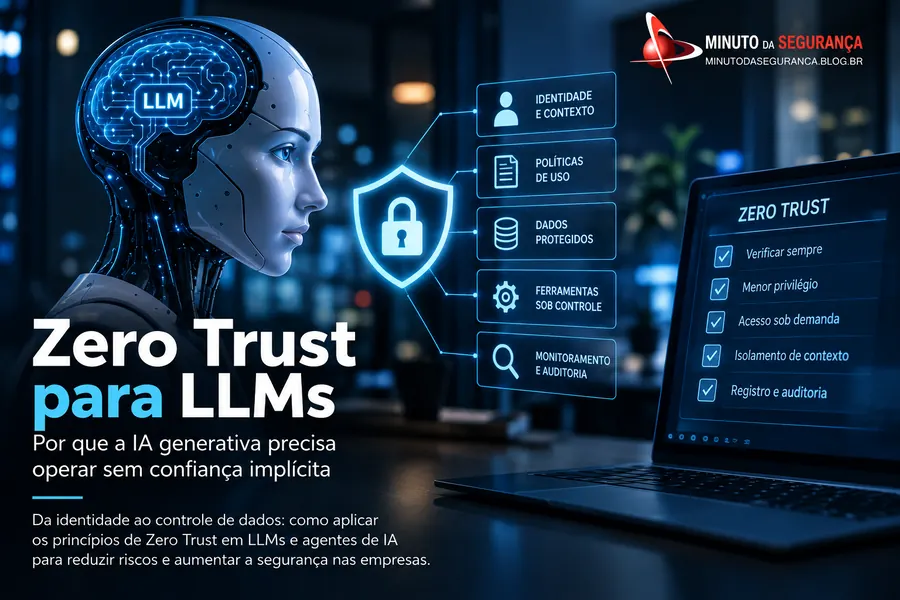
Modelos de linguagem estão deixando de ser apenas interfaces de consulta e passam a acessar documentos, APIs, aplicações, bancos de dados e ferramentas corporativas. Nesse cenário, tratar a resposta do modelo, o prompt recebido ou a identidade do solicitante como confiáveis por padrão cria uma nova superfície de risco.
O projeto open source zero-trust-llm, publicado no GitHub pela MISQE, parte de uma ideia simples e importante: os princípios de Zero Trust também podem ser aplicados à arquitetura de sistemas baseados em grandes modelos de linguagem. Em vez de confiar automaticamente no usuário, na entrada, no contexto recuperado ou na ação proposta pelo modelo, cada etapa deve ser verificada, limitada e observável.
O que muda quando um LLM deixa de ser apenas um chatbot
O risco cresce quando a IA ganha capacidade de agir. Um assistente conectado a bases internas pode recuperar informações confidenciais; integrado a APIs, pode disparar processos; conectado a ferramentas administrativas, pode alterar recursos. A fronteira de segurança deixa de estar somente no login e passa a acompanhar toda a cadeia formada por identidade, contexto, dados, modelo, ferramentas e saída.
Essa mudança aproxima a segurança de IA do princípio clássico de Zero Trust: nunca confiar implicitamente e verificar continuamente. Para LLMs, isso significa validar quem está fazendo a solicitação, quais dados podem entrar no contexto, quais ferramentas o modelo pode utilizar, quais ações estão autorizadas e se a saída pode ser entregue ou executada.
Prompt injection mostra por que confiar no modelo é insuficiente
Um dos exemplos mais claros é a injeção de prompt. Instruções maliciosas podem chegar diretamente pelo usuário ou indiretamente por páginas, documentos, mensagens e outras fontes consultadas pelo sistema. Quando um LLM interpreta esse conteúdo como instrução legítima, controles baseados apenas no comportamento esperado do modelo podem falhar.
A consequência é especialmente relevante em arquiteturas com RAG e agentes. Um documento recuperado pode conter comandos hostis; uma ferramenta pode oferecer privilégios maiores que os necessários; uma resposta aparentemente legítima pode carregar dados que o solicitante não deveria receber. Por isso, guardrails no prompt são úteis, mas não substituem autenticação, autorização, isolamento, políticas e controles externos ao modelo.
Menor privilégio também precisa chegar aos agentes de IA
Aplicar Zero Trust significa impedir que o LLM herde acesso amplo apenas porque está sendo executado dentro do ambiente corporativo. Cada ferramenta deve operar com permissões mínimas, escopo delimitado e credenciais próprias ou delegadas de forma controlada. A autorização deve considerar a identidade do usuário, a finalidade da solicitação, o recurso acessado e o impacto da ação.
Esse desenho reduz o chamado raio de impacto. Mesmo que uma entrada maliciosa consiga influenciar o modelo, a arquitetura limita aquilo que ele consegue consultar, modificar ou executar. A segurança deixa de depender da expectativa de que a IA sempre interprete corretamente uma instrução e passa a depender de controles determinísticos ao redor dela.
Dados, contexto e memória também precisam ser tratados como não confiáveis
Em aplicações corporativas, o contexto enviado ao modelo pode reunir informações de várias fontes e níveis de sensibilidade. A aplicação de políticas antes da recuperação e antes da geração da resposta ajuda a evitar exposição entre usuários, departamentos, clientes ou ambientes. Classificação de dados, filtros de contexto, segregação por tenant e prevenção de perda de dados tornam-se componentes importantes da arquitetura.
A mesma lógica vale para memória e histórico. Informações persistidas por agentes não devem ser reutilizadas indiscriminadamente em novas sessões. É necessário definir origem, finalidade, retenção, autorização e rastreabilidade, principalmente quando o ambiente manipula dados pessoais, propriedade intelectual ou informações reguladas.
Observabilidade transforma confiança em evidência
Zero Trust para LLMs não termina na decisão de acesso. Organizações precisam registrar prompts, chamadas de ferramentas, decisões de política, eventos de bloqueio e resultados relevantes, respeitando os próprios requisitos de privacidade e retenção. Essa telemetria permite investigar incidentes, identificar abuso e demonstrar como uma determinada ação de IA foi autorizada.
O ponto é importante para governança: quanto mais autonomia a IA recebe, maior precisa ser a capacidade de explicar e reconstruir o caminho entre solicitação e ação. A combinação de logs, correlação de identidade, trilhas de auditoria e monitoramento contínuo transforma confiança subjetiva em evidência operacional.
Zero Trust não é um produto para LLM, mas uma arquitetura
O valor do projeto zero-trust-llm está menos em sugerir uma camada isolada e mais em estimular uma mudança de arquitetura. Segurança de IA não deve depender de um único filtro, de uma instrução de sistema ou da promessa de que o modelo recusará comandos perigosos. O desenho precisa assumir que entradas podem ser hostis, contexto pode estar contaminado, saídas podem estar erradas e ferramentas podem ser abusadas.
Na prática, a abordagem combina identidade forte, autorização granular, menor privilégio, segmentação, proteção de dados, validação de entradas e saídas, monitoramento, auditoria e resposta. São controles conhecidos da segurança da informação, agora reposicionados em torno de uma nova camada de decisão probabilística.
Impacto para as empresas
Para organizações que estão conectando IA generativa a processos internos, a discussão deixa de ser apenas tecnológica. Uma autorização excessiva pode resultar em vazamento de informação; uma integração sem segregação pode ampliar impacto entre ambientes; uma ação autônoma sem confirmação pode produzir alteração operacional ou financeira. O risco de IA passa a fazer parte do risco do negócio.
Por isso, projetos de LLM e agentes deveriam nascer com arquitetura de segurança e governança definida desde o desenho. Quanto mais tarde os controles forem adicionados, maior tende a ser a dificuldade de separar identidades, dados, credenciais, ferramentas e fluxos que já foram construídos sobre confiança implícita.
Conclusão
A principal contribuição do conceito de Zero Trust para LLMs é lembrar que inteligência não equivale a confiança. Modelos podem produzir resultados valiosos e, ao mesmo tempo, interpretar conteúdo malicioso, errar decisões ou utilizar permissões de forma inesperada. O caminho mais seguro é projetar sistemas nos quais nenhuma dessas etapas dependa de confiança automática.
À medida que agentes de IA ganham acesso a sistemas corporativos, a pergunta deixa de ser apenas se o modelo é seguro. Passa a ser se toda a arquitetura consegue verificar continuamente quem solicita, o que pode ser acessado, qual ação pode ser executada e quais evidências permanecem depois dela.
Notícias Relacionadas
O papel fundamental da IA generativa na segurança cibernética
IA Generativa e Segurança: é possível conciliar?
Pesquisa projeta o futuro da cibersegurança na era da IA Generativa
Referências
GitHub — misqe/zero-trust-llm
OWASP — Top 10 for Large Language Model Applications
NIST — AI Risk Management Framework
Veja também
Como a IA generativa afeta a segurança móvel
NodeStealer evolui para spyware, rouba senhas e amplia espionagem no Facebook


Be the first to comment