

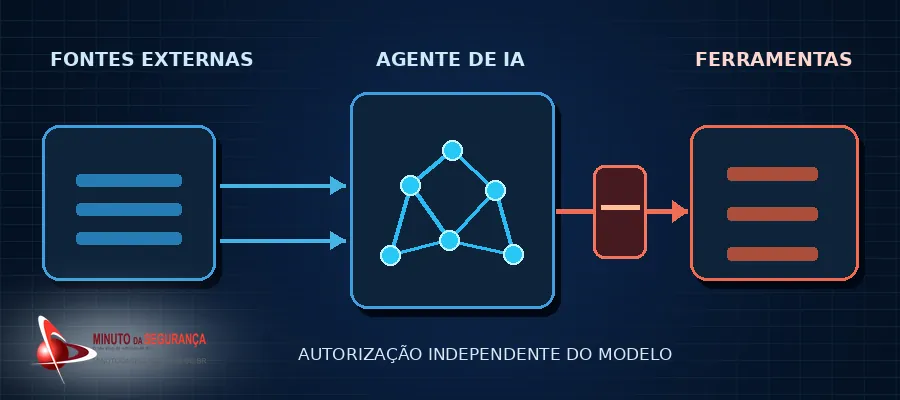
A edição 2026 do OWASP Top 10 para aplicações baseadas em grandes modelos de linguagem (LLMs) coloca em evidência uma mudança na segurança da inteligência artificial corporativa: os riscos já não se limitam à qualidade das respostas produzidas pelo modelo. Quando um agente consulta documentos internos, acessa e-mails, executa ferramentas e altera sistemas, uma instrução manipulada pode transformar-se em uma operação não autorizada. O relatório mantém a injeção de prompts na liderança e eleva a concessão de autonomia e privilégios excessivos à terceira posição.
Publicado em agosto pelo OWASP GenAI Security Project, o novo levantamento atualiza a classificação de ameaças para aplicações com IA generativa e incorpora evidências de vulnerabilidades e incidentes documentados. A divulgação ganhou atenção renovada em outubro, quando a Cyber Security Brazil destacou as implicações para empresas que conectam agentes a bancos de dados, serviços em nuvem e processos de negócio. A edição de 2026 deve ser lida como um instrumento de priorização e arquitetura, não como uma estatística segundo a qual toda aplicação de IA sofrerá os mesmos ataques.
A metodologia informada na cobertura reúne 7.714 registros, dos quais 6.639 apresentavam dados suficientes para classificação. O julgamento da comunidade técnica recebeu peso de 75%, e os registros documentados, 25%. Esses números não representam 7.714 invasões confirmadas: abrangem categorias diferentes de ocorrências e fontes. A distinção importa porque o ranking expressa uma combinação de experiência profissional, exposição técnica e evidência pública, e não uma medição direta da frequência de ataques em todas as empresas.
O ranking de 2026 e o que mudou
A relação completa, na ordem apresentada pela OWASP para aplicações com LLMs em 2026, é a seguinte:
- Prompt Injection — Injeção de prompts: instruções maliciosas em mensagens, documentos ou conteúdos externos podem desviar o comportamento da aplicação.
- Sensitive Information Disclosure — Divulgação de informações sensíveis: dados confidenciais podem ser expostos em respostas, contextos, integrações ou registros.
- Excessive Agency — Autonomia excessiva: agentes recebem funcionalidades, permissões ou liberdade de execução além do necessário.
- Supply Chain — Cadeia de suprimentos: modelos, bibliotecas, conectores, conjuntos de dados e outros componentes de terceiros podem introduzir vulnerabilidades.
- Data and Model Poisoning — Envenenamento de dados e modelos: alterações maliciosas em dados ou modelos comprometem resultados e comportamentos.
- Unbounded Consumption — Consumo ilimitado: operações sem limites adequados podem causar indisponibilidade, abuso de recursos e custos inesperados.
- Misinformation — Desinformação: respostas incorretas ou fabricadas podem induzir decisões equivocadas quando tratadas como confiáveis.
- Hidden Context Exposure — Exposição de contexto oculto: instruções internas, configurações e outros elementos de contexto podem ser revelados.
- Vector and Embedding Weaknesses — Fragilidades em vetores e embeddings: problemas em índices, buscas semânticas e isolamento de dados podem expor informações ou contaminar respostas.
- Improper Output Handling — Tratamento inadequado das saídas: resultados gerados pelo modelo podem provocar falhas quando executados ou processados sem validação.
O prompt injection continua na primeira posição, seguido pela exposição de informações sensíveis. A terceira colocação agora pertence a Excessive Agency, categoria que trata de funcionalidades, permissões e autonomia concedidas além do necessário. Na sequência aparecem os riscos da cadeia de suprimentos, o envenenamento de dados e modelos, o consumo ilimitado de recursos, a desinformação, a exposição de contexto oculto, as fragilidades em vetores e embeddings e o tratamento inadequado das saídas do modelo.
A nova ordem revela uma preocupação prática: quanto mais aplicações de IA passam a executar ações, maior é o impacto de uma decisão equivocada. Um assistente que apenas responde a perguntas pode produzir uma orientação incorreta. O mesmo assistente, quando autorizado a excluir arquivos, criar usuários ou aprovar operações financeiras, pode converter o erro em dano operacional. A OWASP recomenda que permissões e aprovações sejam implementadas fora do modelo, em componentes capazes de validar cada solicitação independentemente do texto gerado.
Na injeção de prompts, o atacante tenta introduzir instruções em conteúdo que a aplicação deveria tratar apenas como dado. Uma página recuperada da internet, um documento, uma mensagem de e-mail ou uma resposta de ferramenta podem carregar comandos destinados a alterar o comportamento do agente. O problema não exige necessariamente que o invasor tenha acesso direto à interface do chatbot. Em setembro, o Blog Minuto da Segurança noticiou o caso de uma petição em que o STF identificou comandos ocultos destinados a influenciar sistemas de IA — um exemplo brasileiro de como documentos aparentemente legítimos podem funcionar como veículo de manipulação.
A exposição de informações sensíveis, segunda categoria, também ultrapassa o ato de copiar dados confidenciais para uma ferramenta pública. Informações protegidas podem ser recuperadas automaticamente por um mecanismo de RAG, incluídas em históricos, registradas em logs ou repassadas a integrações que não preservam os direitos de acesso originais. A verificação de permissões deve ocorrer antes de o dado entrar no contexto do modelo; ocultar o resultado apenas na resposta final pode ser insuficiente.
Os riscos que não aparecem na interface do chatbot
A cadeia de suprimentos ocupa a quarta posição porque uma aplicação depende de muito mais do que o modelo principal: bibliotecas, conectores, datasets, adaptadores, ambientes de execução e serviços de terceiros também podem ser comprometidos. Na quinta posição, o envenenamento de dados e modelos considera a introdução de informações manipuladas no treinamento, ajuste ou recuperação, inclusive comportamentos que permanecem ocultos até que determinada condição seja acionada. Inventário, procedência, integridade e rastreabilidade dos componentes tornam-se parte do trabalho de segurança.
O consumo ilimitado de recursos, em sexto lugar, pode provocar indisponibilidade ou gastos inesperados mesmo sem um atacante externo. Agentes que entram em ciclos, repetem chamadas a APIs pagas ou executam tarefas sem condições claras de encerramento exigem limites técnicos de custo, duração e quantidade de etapas. Um alerta enviado depois que a conta de processamento disparou não substitui um mecanismo capaz de interromper a operação.
A desinformação, sétima colocada, inclui respostas plausíveis, porém falsas, e conclusões sem sustentação. Em processos corporativos, o problema pode aparecer quando um agente declara que um backup foi concluído sem verificar o sistema responsável ou produz uma análise de risco baseada em fontes desatualizadas. A mitigação exige evidências verificáveis, confirmação de operações e separação entre o que o modelo afirmou e o que o sistema efetivamente executou.
Na oitava posição, Hidden Context Exposure amplia o antigo conceito de vazamento de prompts de sistema. Instruções internas, descrições de ferramentas e partes do contexto podem ser reveladas ou reconstruídas; por isso, segredos, tokens e credenciais não devem ser colocados em prompts. A nona categoria aborda vetores e embeddings, usados em busca semântica e RAG: índices compartilhados e filtros de acesso inadequados podem permitir que informações de um cliente apareçam para outro. A décima trata do uso inseguro das saídas, como quando texto gerado é encaminhado diretamente a comandos, consultas ou páginas sem validação e codificação apropriadas.
O que o Top 10 exige das empresas brasileiras
Para organizações que já utilizam IA em atendimento, desenvolvimento, análise documental, segurança ou operações administrativas, o primeiro passo é mapear quais modelos e agentes estão em uso, quais dados recebem e quais sistemas podem consultar ou modificar. Esse inventário precisa incluir soluções contratadas, ferramentas adotadas informalmente e integrações feitas por equipes internas. A partir daí, é possível estabelecer fronteiras de confiança: o conteúdo recuperado não pode ganhar autoridade de comando, e uma ferramenta não deve executar operações apenas porque o modelo solicitou.
Na prática, controles de identidade e acesso precisam aplicar o menor privilégio também aos agentes. Uma integração destinada à consulta deve operar com credenciais somente de leitura. Ações que alterem permissões, movimentem recursos financeiros, apaguem informações ou afetem ambientes de produção exigem autorização independente e, quando apropriado, aprovação humana. Logs e trilhas de auditoria devem permitir reconstruir quem solicitou a ação, quais ferramentas foram chamadas, que dados foram acessados e qual foi o resultado real da operação, com proteção adequada para evitar que esses registros se tornem uma nova fonte de vazamento.
Os testes de segurança devem simular entradas hostis em documentos, resultados de busca, mensagens e respostas de APIs, além de verificar isolamento entre usuários, limites de consumo, controle de permissões e falhas de validação das saídas. A OWASP oferece um referencial para organizar esse trabalho, mas não substitui análise de arquitetura, avaliação de riscos e testes específicos do ambiente. Para aplicações com agentes autônomos, o projeto também mantém orientações complementares voltadas a sistemas agênticos.
O principal recado da edição de 2026 é que a segurança da IA não pode depender apenas de um prompt que peça ao modelo para se comportar corretamente. Quando a inteligência artificial participa de processos reais de negócio, as decisões de autorização, a proteção dos dados e os limites operacionais precisam continuar sob o controle de mecanismos verificáveis. É nessa separação entre a resposta do modelo e o poder de agir que se decide boa parte do risco corporativo.
Be the first to comment